Metadados, memória e procedência no WIAD 2024
No WIAD São Paulo de 2024, minha pesquisa sobre metadados voltou ao debate para discutir memória, recuperação e procedência. Dois exemplos de busca (uma resposta de IA que não trouxe a fonte primária e um destaque sem contexto) mostram como decisões de design interferem no que conseguimos compreender.
O que uma pesquisa sobre metadados, iniciada quase quinze anos antes, baseada em informação jornalística, tem a ver com arquitetura da informação?
Opa. Design é a chave dessa resposta. Pude confirmar essa hipótese em muma fala no World Information Architecture Day, edição local de um evento global organizado pelo UXPA.
Pergunta antiga, auditório diferente
“Eu venho do Jornalismo, não do design”. Minha apresentação começou onde minha pesquisa sempre se ancorou: informação como base de conhecimento estruturado, camadas semânticas, a buzzword do “conteúdo inteligente”. Território onde me sinto em casa.
Mas o Jornalismo é “arrogante”, Falar de interoperabilidade pressupõe que a essa informação já está organizada o bastante. É como se, ao publicar uma página, contextualizar para a leitura imediata e mantera URL pública é suficiente para preservar seu significado ao longo do tempo.
Mas uma reportagem pode ser compreensível para seu público agora e, ainda assim, difícil de recuperar depois. Piora quando ela passa a circular em outros sistemas: motores de busca, agregadores, modelos de linguagem…
A arquitetura da informação oferece caminhos para tratar desse problema. Mas suas classificações, hierarquias e vocabulários também carregam pressupostos e escolhas. Não estão livres da mesma arrogância só por pertencerem a outra disciplina.
Duas palavras sobreviveram
De todo o repertório da apresentação, duas concentraram o que valia a pena deixar registrado: memória e procedência.
Memória significa criar, manter e disponibilizar dados conectados e abertos, preservando história nesse ecossistema que tende ao efêmero.
Procedência quer dizer origem, intenções e associações. Atributos objetivos que apoiam um julgamento inerentemente subjetivo: relevância.
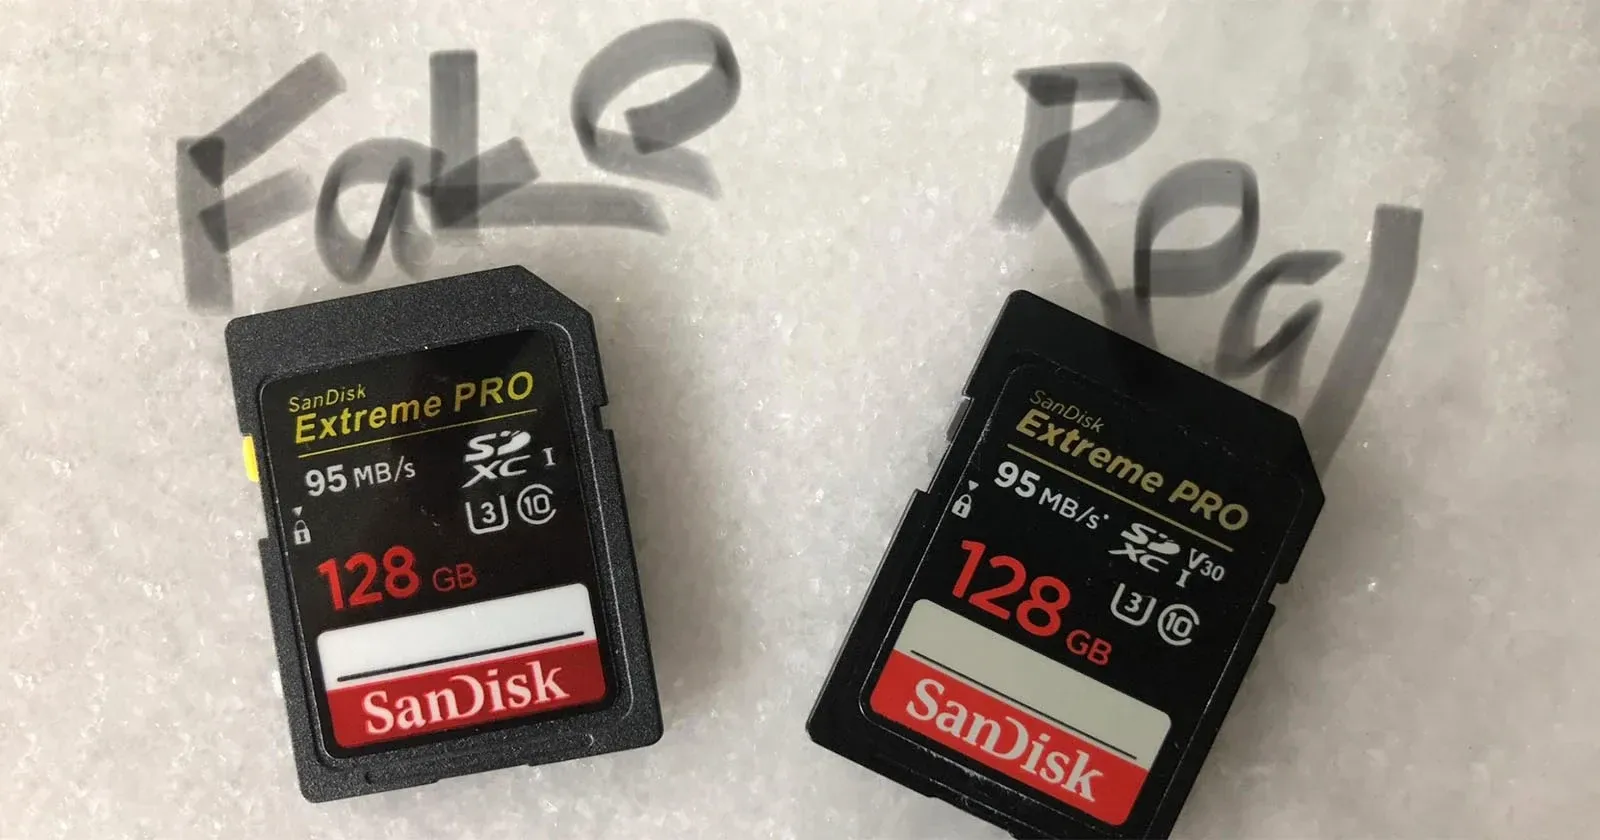
O slide que abria esse bloco trazia dois cartões de memória SD idênticos, um rotulado à mão como “falso” e o outro como “real”. A pergunta por trás da imagem era literal: como saber qual memória é a confiável?
“Resposta boa” e “resposta certa” são coisas diferentes
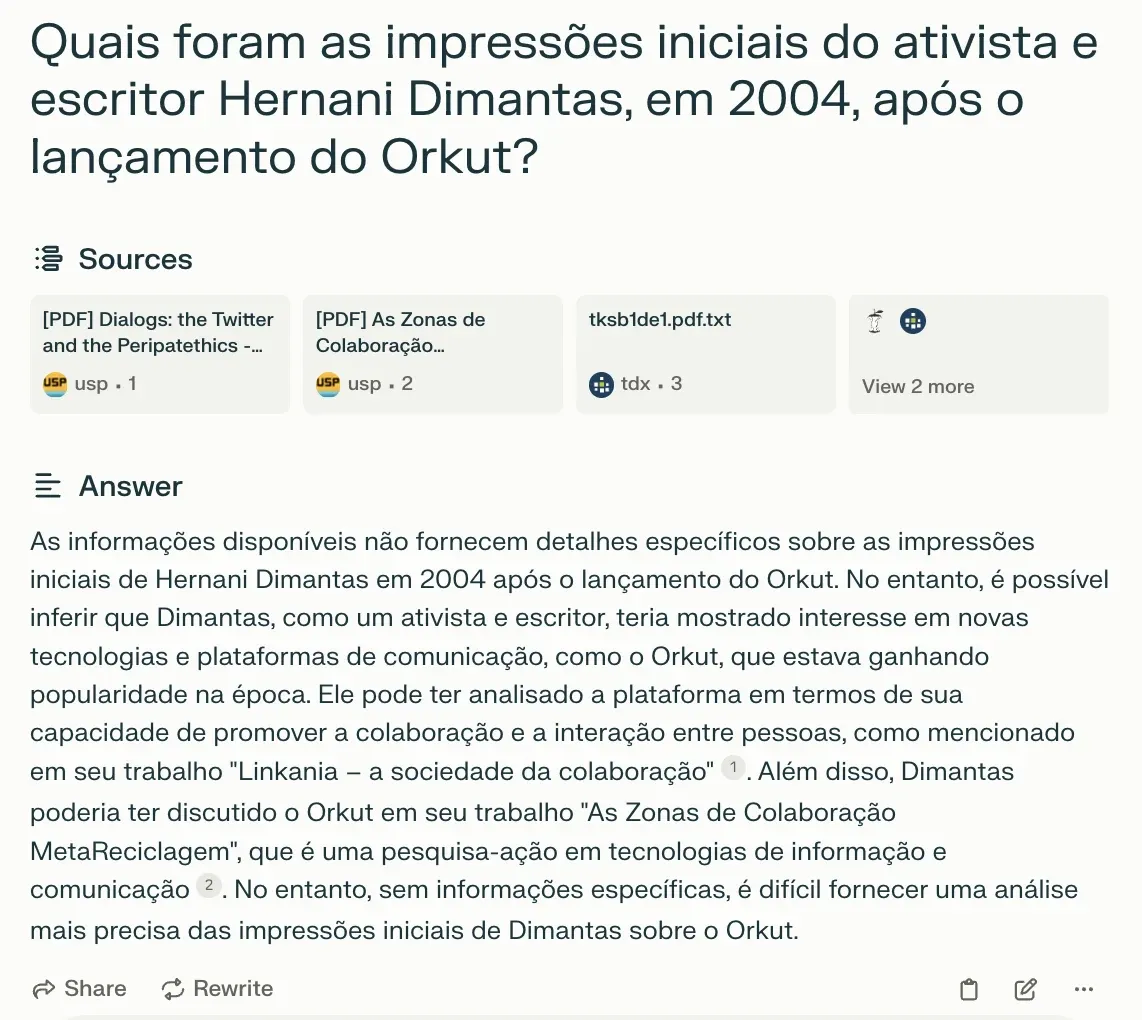
Fiz um experimento simples: perguntar a uma ferramenta de busca com IA, com citações acadêmicas, quais foram as impressões iniciais do pesquisador e escritor Hernani Dimantas sobre o Orkut, logo após o lançamento da rede, em 2004.
A resposta veio bem construída. Fontes indicadas, parágrafos organizados, ressalvas nos lugares certos: “as informações disponíveis não fornecem detalhes específicos […] é possível inferir […] sem informações específicas, é difícil fornecer uma análise mais precisa”.
Só que a resposta certa já existia. Foi publicada em depois do lançamento do Orkut, em janeiro daquele ano, no blog pessoal de Dimantas, em primeira pessoa, com data e assinatura: “Quando o Orkut funciona!”.
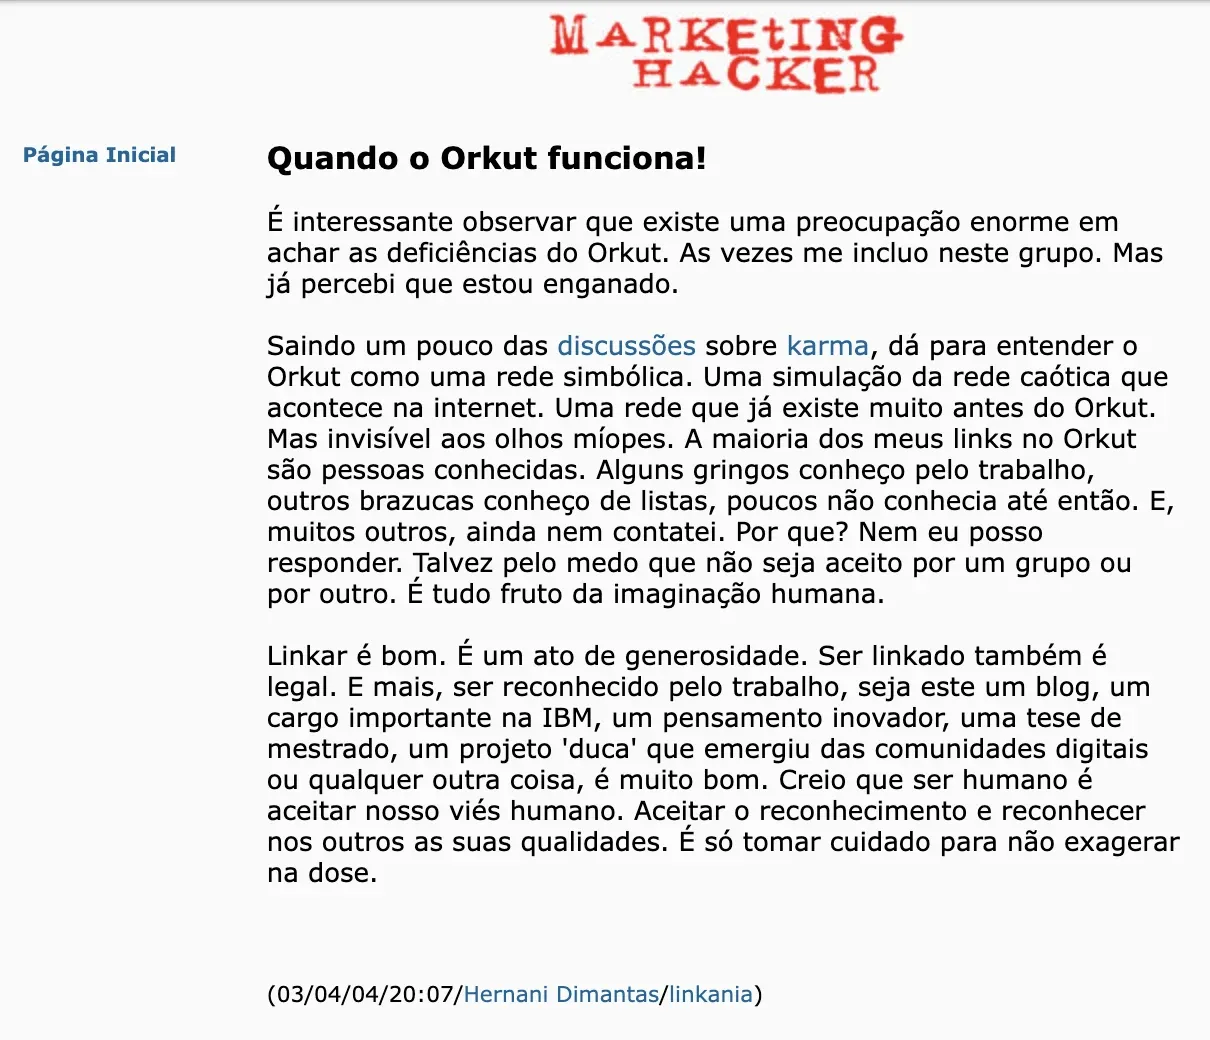
A ferramenta reconheceu os limites das fontes que conseguiu reunir. A resposta já vinha com notas e ressalvas. Ainda assim, deixou de recuperar um registro relevante. O exemplo expõe três exigências diferentes e fáceis de confundir sob o mesmo rótulo. A primeira: memória tem a ver com preservar registros para que continuem disponível. A segunda: recuperação, conseguir encontrá-lo quando ele se torna a fonte que importa. Finalmente, procedência: permitir que quem lê identifique a origem do que está sendo afirmado e avalie o que ela sustenta.
Quem a base de dados serve
O segundo exemplo levava a mesma lógica a um terreno mais desconfortável: uma busca no Google por “tai nalon é de esquerda” devolvia, em destaque, um trecho de um site sem credibilidade. Trazia uma distorção do perfil da jornalista e fundadora de uma agência de fact-checking para atacar conservadores de forma disfarçada.
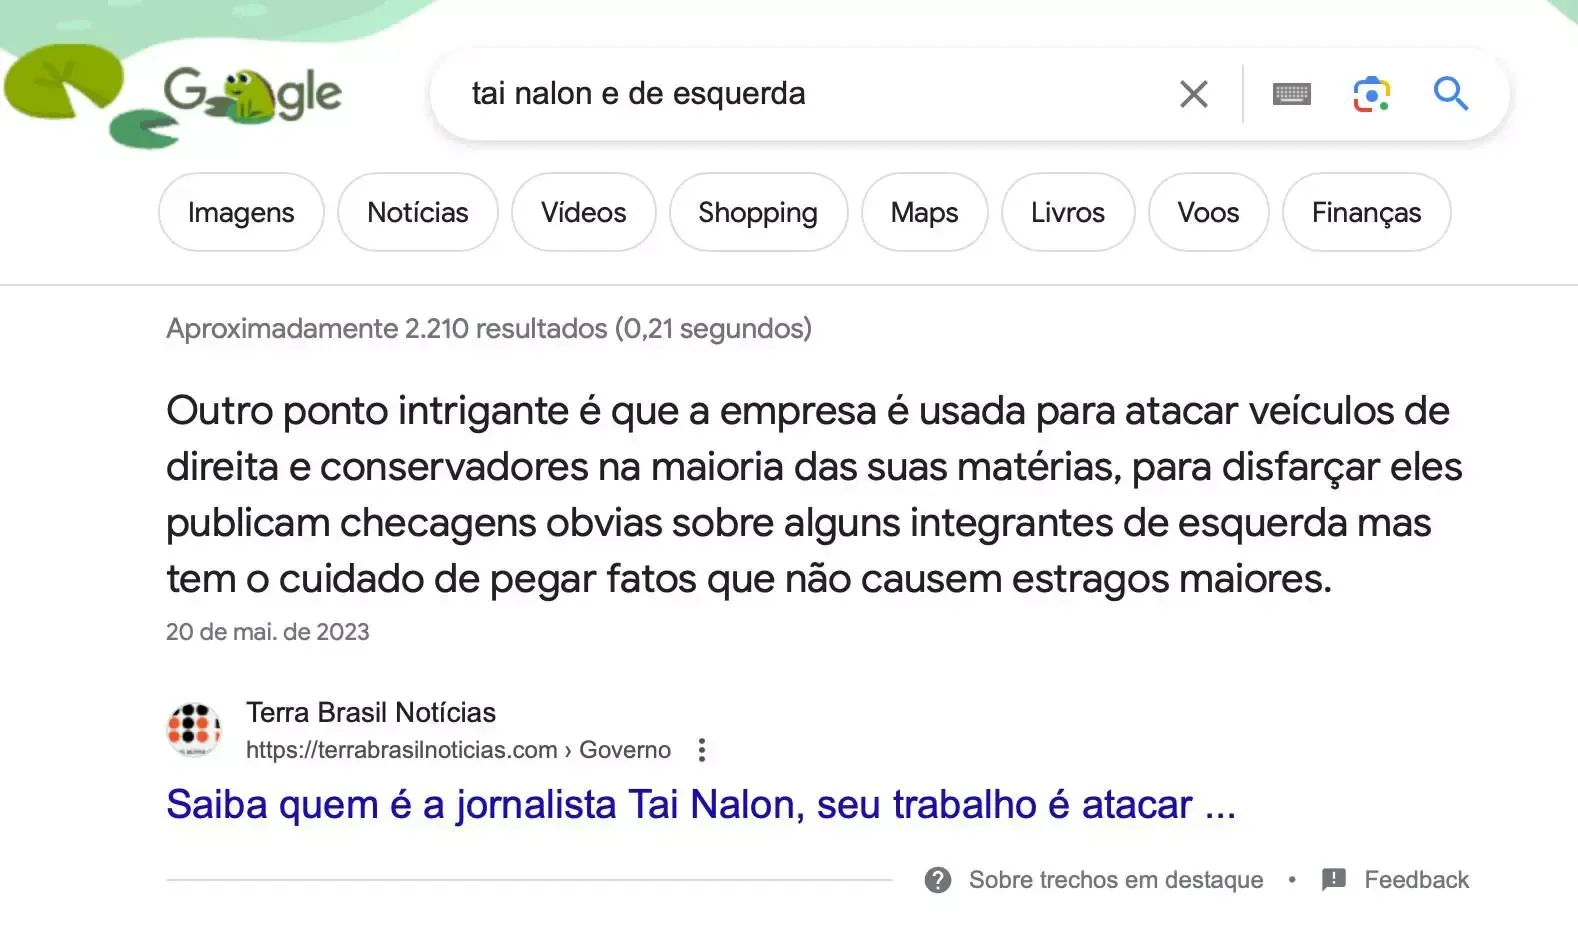
A origem, ali, estava identificada: o resultado indicava o site de onde vinha o trecho. Mas faltava contexto para avaliar o que estava sendo citado. Reconhecer e destacar um trecho e apresentá-lo como resposta é uma decisão editorial, mesmo com o aparente discurso do “foi o algoritmo”. Organizar informação nunca é uma operação neutra.
A resposta está no design?
Essa é minha hipótese mais recente. Na palestra, terminei minha fala levantando a pergunta.
Nos dois exemplos, havia informação disponível. Em um, faltou recuperar a fonte primária certa. No outro, faltou contextualizar a fonte que já estava à vista. Em ambos, decisões sobre busca, organização e apresentação definiram o que quem lia podia compreender.
Memória, recuperação, procedência, semântica, estruturação por metados… Até onde essas coisas dão conta? A partir de que ponto a pergunta deixa de ser técnica e passa a ser sobre os valores e interesses que orientam o desenho dos próprios sistemas?
Essa é a questão que nos leva aos próximos passos.